 Parker
Claude Code 团队怎么审代码
在 agent 产出代码的这个量级上,代码该怎么审?
我们之前说过,Claude Code 自己的代码里大约 90% 是 Claude 写的。那么,在这个产出量级上我们怎么审查代码?还有人读代码吗?如果出了问题,谁来接住?
这篇文章讲的是 Claude Code 团队现在的代码审查流程,以及它是怎么演变过来的。从六月到九月,合并进 Claude Code 代码库的 PR 数量翻了一倍多,而其中需要回滚的比例反而下降了 40% 以上。
我们没有取消审查。我们只是把大部分阅读交给了机器,围绕人的时间和注意力重新做了优化,并且在「让错误能被快速、轻易地撤销」上投入很多。
重新理解代码审查的目的#
当 agent 写代码时,改动的数量涨得飞快。在 Anthropic 的 monorepo 里,每天落地的改动从五月的约 2,500 次涨到了今年九月的 30,000 多次。
Claude Code 有自己的仓库,不在那个 monorepo 里,但压力同样很大。以这种速度交付,逐行的人工审查即便不是不可能,也极其困难。
代码审查要做两件事:
- 在上线之前发现并修复问题
- 在团队里建立共享的上下文和对代码库的理解
这篇文章主要谈第一件,第二件放到最后再说。
我们认为,「有没有人读过这段代码」是个不太精确的替代指标。真正该问的是:「这次改动可能出什么问题,哪一道检查——自动的还是人工的——才是抓它最合适的那道?」
换成这个问题之后,审查发生的时机也变了。以前,审查是路尽头的一道闸门:写完代码,开一个 PR,等同事来看。
现在,审查是持续进行的,更像你打字时的拼写检查。大多数改动在被要求人看之前,已经被 Claude 至少审过、修过一轮。这样能抓住大部分常规错误,把团队的注意力留给更高层的问题和审视。
稀缺的是人的时间和注意力#
我们希望把人的时间和注意力留给只有人能解决的问题,其余的交给自动检查兜住。以现在的改动速度,人要做的事仍然多得惊人,团队几乎每天都在遇到新的、没见过的问题。
「人的时间」包含审查成本的两面:一是花在审查上的时间,二是花在收拾烂代码造成的后果上的时间。如果省下的第一种时间又跑到第二种里去,那等于没省。
所以目标是:Claude Code 各个仓库(CLI、桌面端和 Web 端、移动端)里的大多数 PR,最多经过一个真人就能合并——这个人可以就是作者本人——同时回滚率和事故率不上升。为了度量人的时间,我们跟踪每个 PR 上的人工批准次数(中位数和 95 分位)、人工评论数,以及 PR 因为等人而停留的时长。回滚率和事故率是护栏:它们一涨,就说明我们没有省下人的时间,只是把时间挪了个地方。
一次改动的一生#
一次典型的改动,从工程师的笔记本(或者 Slack 里的一个 Claude 会话)出发,要穿过好几层审查。
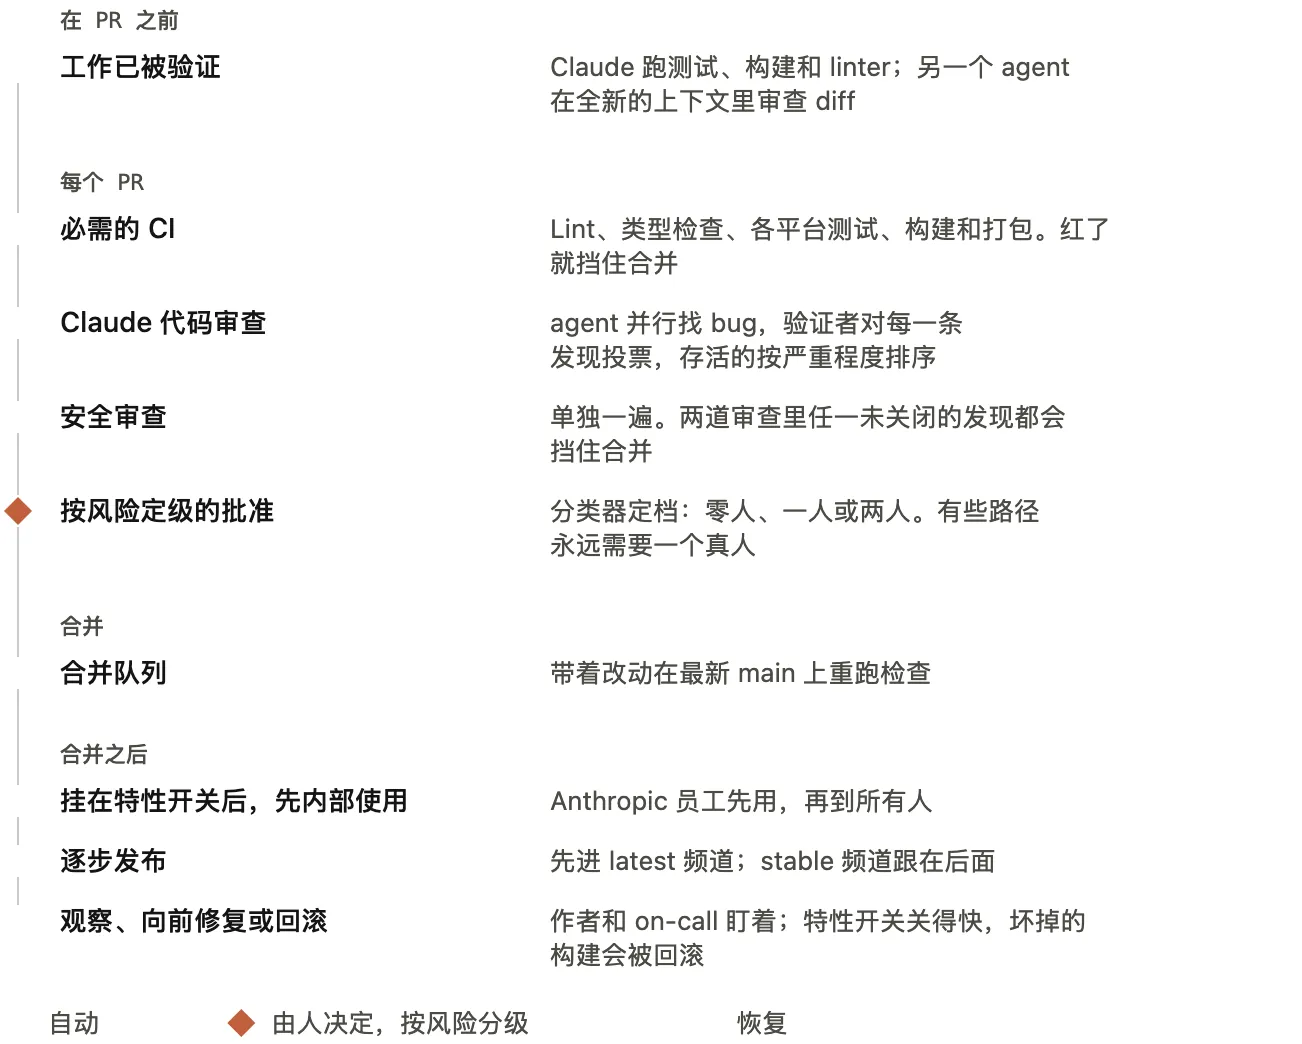
逐层看#
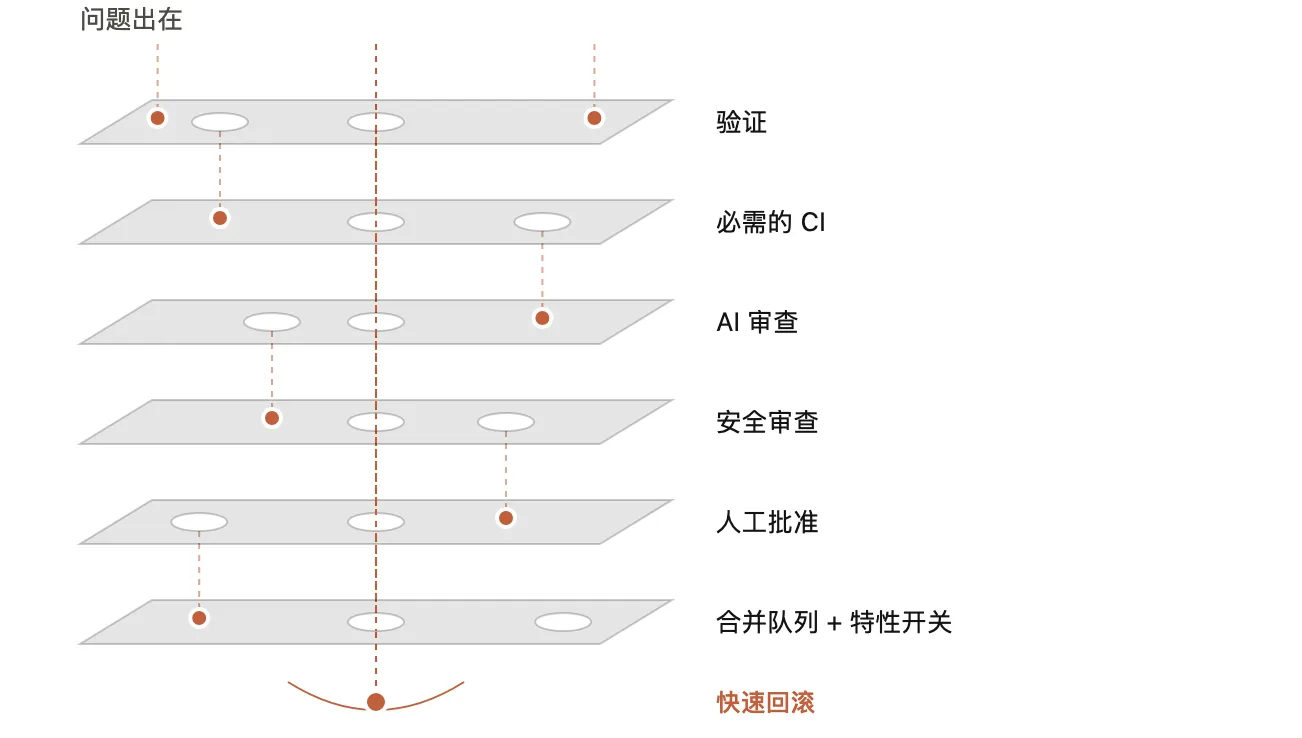
1. 在别人看之前,工作已经被验证#
现在大部分审查发生在 PR 存在之前。我们给 Claude 一些它能跑的东西——测试、构建,或者一张可以跟设计稿对比的截图——要求它拿出输出,而不是嘴上说「做完了」。然后让一个 subagent 用全新的上下文再把 diff 审一遍。这两个习惯都来自我们的最佳实践指南。
开 PR 之前,我们中不少人还会跑几个内部 skill:一个专门找 bug,一个精简 diff,一个做端到端的行为检查。UI 改动还会额外对照设计规范检查一遍。
Claude Code 的作者 Boris Cherny 说过,给 Claude 一个验证自己工作的手段,大概是拿到好结果最重要的一件事。他估计这能让最终结果好上两到三倍。他写道:「验证的方式因领域而异。可能只是跑一条 bash 命令,跑一遍测试,或者在浏览器、手机模拟器里把 app 点一遍。」
当自动审查反复指出同一类问题,我们就在源头修:改 skill、加 lint 规则,或者更新这些说明文件:
CLAUDE.md告诉 Claude 这个项目是什么:技术栈、约定、目标和「非目标」。每次审查都会加载它,所以在大型代码库里我们把它写得很短,其余的内容从这里指出去。审查者也会标记违反其中约定的代码,以及那些让里面某一行过时的改动。REVIEW.md由代码 owner 写,告诉审查者自己这块代码里什么才算要紧。我们会单独检查审查者是否真的照做。写得好的都很短:说清楚这个仓库里「出问题」长什么样(文档仓库是「它在说谎」,配置仓库是「它把流量路由错了」),限制吹毛求疵的意见数量,列出可以跳过的路径,并且要求给出文件和行号作为证据,而不是凭名字猜。它们还会要求总结以数字开头,没什么可修的时候要直说。
2. 每个 PR 都过 AI 审查#
每个 PR 在人看之前都会先过一遍 Claude 审查。它把 diff 放到整个仓库和 PR 声明的意图里读,然后问:这个改动解决了它要解决的问题吗,融进了系统吗,会不会弄坏别的东西?
如果是修 bug 的 PR,它会去找根因。对外的版本叫 Code Review for Claude Code,现在已经在 Team 和 Enterprise 套餐上正式可用;/code-review 在本地跑的是轻量版。
做研究预览版的时候,内部 PR 里能拿到实质性审查意见的比例从 16% 涨到了 54%。超过 1,000 行的 PR 大多能被找出问题,小的那些大多干净通过。管理员可以给每个仓库设 Quick、Standard 或 Deep。在「漏一个 bug 的代价高于多花的那点审查时间」的地方,Deep 是值得的。
在让人看之前,发现的问题会先被别的 agent 验证一遍。几个 agent 同时找 bug,然后另一组 agent 对每一条发现投票,票数够多才会被发出来。只涉及风格、诊断信息或者清理工作的发现会被丢掉。这些过滤规则在我们自己的 PR 上做过 A/B 测试,才保留下来。剩下的以行内评论的形式按严重程度排序出现,每条都标成 Important、Nit 或 Pre-existing——这样不是这个 PR 引入的 bug,看起来就不像是作者的责任。
每一条发现都必须有交代。要么修掉,要么在讨论串里写清理由再关闭。经常是夜里某个 agent 就把修复做了,作者第二天回来,发现 PR 已经又过了一轮。
3. 能卡住合并的安全审查#
安全也有自己的一套自动审查。只要 bug 审查或安全审查里还有任何一条发现没关掉,PR 就不能合并。你要么修,要么用一句简短的理由把讨论关掉——误报就是这么排除的。
如果后续的提交把问题修好了,这条发现会自动消失。你也可以用开源的 security review GitHub Action 或者 /security-review 命令,搭出一模一样的效果;配置方式见 Claude Code 里的自动化安全审查。
4. 会卡住合并的自动检查#
常规的那些:lint、类型检查、各平台的测试、构建。(为了扛住这个量,我们怎么扩 CI,写在这里。)一个典型的 CLI PR 在人看之前可能已经跑了几十项检查。PR 模板会问这个改动怎么测的、怎么撤销。Claude 可以替你填,但最终要为它签字的是提出改动的那个人。
5. 按风险分级的人工批准#
改一段文档和改自动更新器,风险完全不同,审法也应该不同。
| 风险 | 例子 | 需要几个真人批准 |
|---|---|---|
| 低 | 文档、文案、仅内部可见的功能、挂在开关后面的增量改动 | 自动审查和安全检查通过后,不需要人 |
| 中 | 常规产品改动,以及缓存、自动更新器、系统提示词这类敏感区域 | 一个人 |
| 高 | 风险最高的代码,加上一小撮永远需要两个人的路径 | 两个人 |
定级的是改动本身,不是作者。一个分类器读这个改动,定出它的风险等级。第二个分类器再问:即使这个等级说不需要人,这次改动是否仍然需要多一个人?有些路径永远需要人:owner 标注为敏感的任何东西,以及所有 CI workflow 文件。
只有可信作者才走轻路径。只有在仓库 trusted 列表里的作者才能走轻量路径,这份名单基本就是拥有这个仓库的团队。其他人一律需要第二个人批准。agent 的批准也永远不能算作一个人的。自动审查可以让一个低风险改动通过,但它填不了需要真人的那个位置。
谁提出这个改动,谁就得担着。对 agent 写的 PR,指挥这个 agent 的人算作必需审核人之一,就跟他自己敲了这些代码一样。
一次批准只覆盖一个特定的提交。如果之后又来了系统不能为之担保的提交——比如 agent 推的,或者有人手工解冲突合并出来的——批准就得重新给。
6. 合并队列、开关和逐步发布#
合并队列会带着这次改动、对着最新的 main 把所有检查再跑一遍,这样两个各自都能通过的 PR,不会合在一起变成坏掉的 main。新行为通常先挂在开关后面发给 Anthropic 员工,我们自己用得很重,往往在用户之前就把回归问题踩出来。对外发布先进 latest 频道,stable 频道跟在后面。
7. 快速发现,快速回滚#
总还有些错误会漏过来,所以最后一层要解决的是「发现得够快」。开关不用发版就能关掉。Claude Code 有按周轮值的 on-call,事故复盘会问:这个问题本该是哪一层抓住的?
能不能及时注意到一次糟糕的合并,目前仍然靠作者、on-call,以及回滚和事故看板。我们还没有做「数据一动就自动收紧批准」的熔断器;这里的工程师希望在有更多代码走向「零人工合并」之前,先把它做出来。
有位同事说,慢下来确实能降低错误率,但那主要是因为你什么都做得更少了。与其慢下来,我们宁愿在「更快发现、更快修好」上下功夫。
我们怎么把审查者变好#
我们的审查流程是在一个循环里不断改进的。
每一次事故现在都是一条 eval。团队把过去引发事故的 PR 收集起来,连同它们的向前修复和回滚,请熟悉那段代码的工程师逐条确认 bug 长什么样、出在哪儿。审查者每天在这个集合上跑一遍。
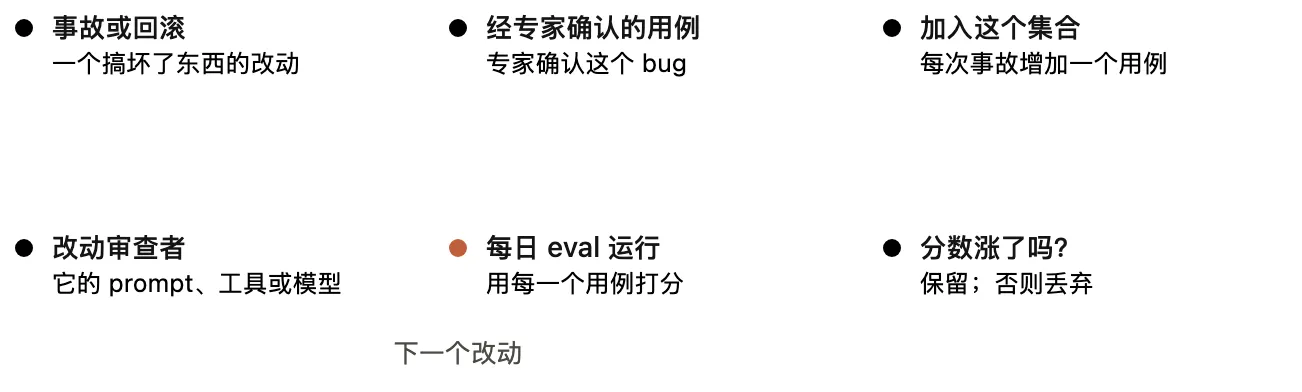
我们通过看人怎么处理这些评论来衡量噪音。如果不在乎顺手标一堆不是问题的问题,多抓几个 bug 是很容易的,所以这需要一个约束。审查者留下的每条评论,都按 PR 上那个人的反应分类:他修了、他说这条是错的、他说这个行为是故意的、他觉得无所谓。我们还会拿它去跑那些我们确信干净的 PR,统计它报出「照做反而有害」的东西的频率。写在纸上的优先级是:先抓真 bug,再减少审查轮数。
作者是 agent 时,噪音的代价更高。人几秒钟就能把一条吹毛求疵的意见挥开;agent 会去修它,那就多一次提交、多一轮审查。
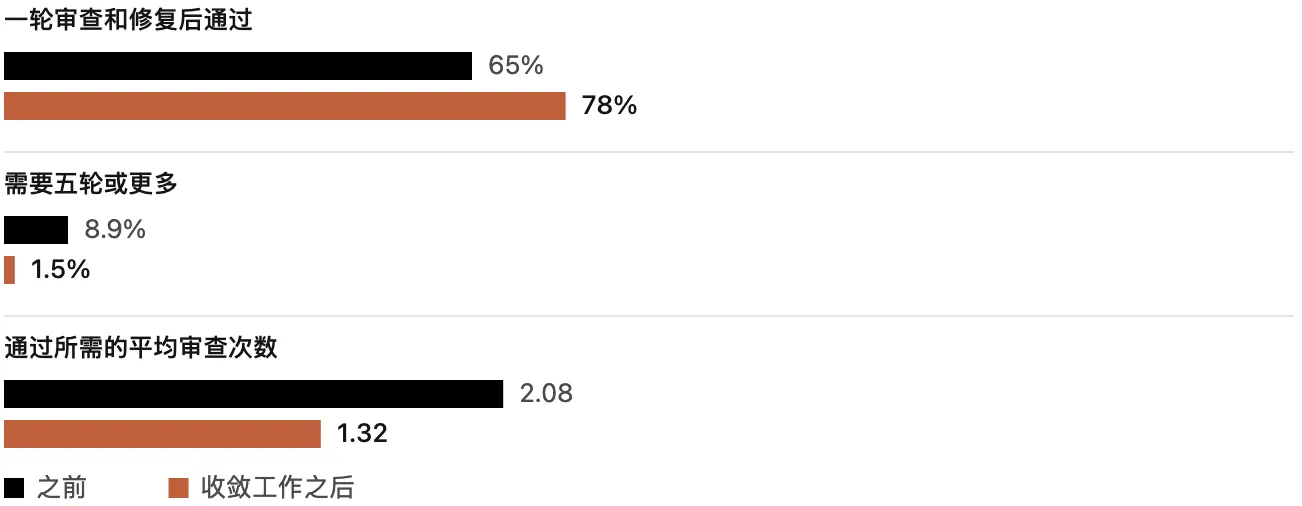
审查必须收敛。agent 作者配 agent 审查者,可以让彼此永远忙下去。有一个 CLI PR,一夜之间过了五十多轮审查和修复,最后是作者叫停的。
我们对审查者反复指出的那些行跑了 git blame,发现大约 59% 是审查者第一次看时就已经在那儿的代码。它很少在找新的 bug,只是每一轮多找出几个旧的。
我们自己让它变得更糟了。我们习惯了默认跑好几轮,因为每一轮都能抓出点新东西。这在有风险的改动上也许值得,但不必每个 PR 都这样。团队现在把「通过所需轮数」和召回率放在一起看,并且改了复审方式:
- 轮数上限。超过三轮,审查者会请作者退一步,重新考虑方案本身。
- 只审新 diff。前几轮之后,复审只看新增的部分。
- 标出 bug 的类型,让作者把所有同类的地方都修掉,而不是只修一行。
- 不重复。已经发过的发现不再重复出现。
审查 agent 还会每晚跑一遍存量代码,帮我们在老 bug 以别的方式冒出来之前先抓住它。
人还留在哪些环节#
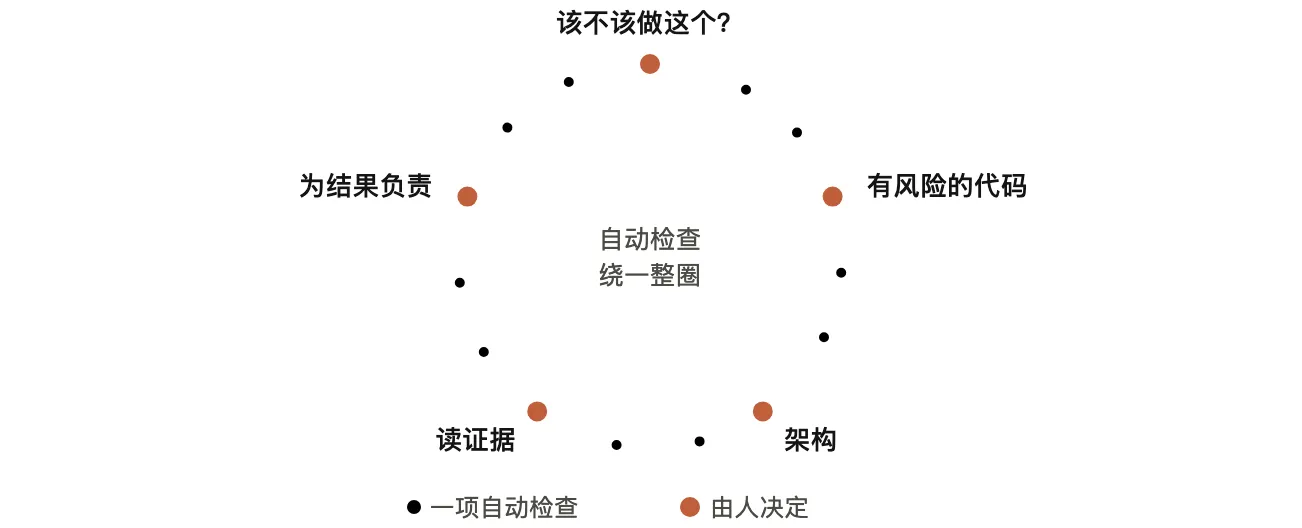
把一个资深工程师从深度工作里拽出来,只为抓一个常规错误,代价远高于一次自动审查。在 Anthropic,我们的工作已经从「读每一个 diff」变成了「做机器不擅长的那些决定」:
- 这东西到底该不该做?方向、品味和范围。有个团队宣布自己的审查瓶颈已经解决了,但对外团队来的改动仍然保留人工审查,就是为了有人能问一句「这事我们真的要做吗?」
- 有风险的代码,比如计费、自动更新器和 CI workflow。
- 定下模式的架构,那种别人会照着抄的。
- 读证据。测试输出、跑了什么命令、返回了什么、截图、审查者的发现。如果你说不出这些检查会漏掉什么,那就要求一次真正的审查,而不是顺手点个通过。
- 为结果负责。每一个上线的改动,都得有一个人担责,不管代码是谁敲的。
团队里怎么共享上下文#
代码审查的第二个职责,一直是把对代码库的理解散播开。读同事的 diff,是了解「改了什么、各块怎么拼起来」的方式。如果大部分阅读交给机器,那大家还怎么学这套代码?
这件事我们没有正式流程。团队里没有人脑子里装着 Claude Code 的完整心智模型,我们也不认为有谁需要。谁想搞懂代码库的某一块,就让 Claude 专门为这一块写一份讲解。几分钟就好,而且反映的是今天的代码。
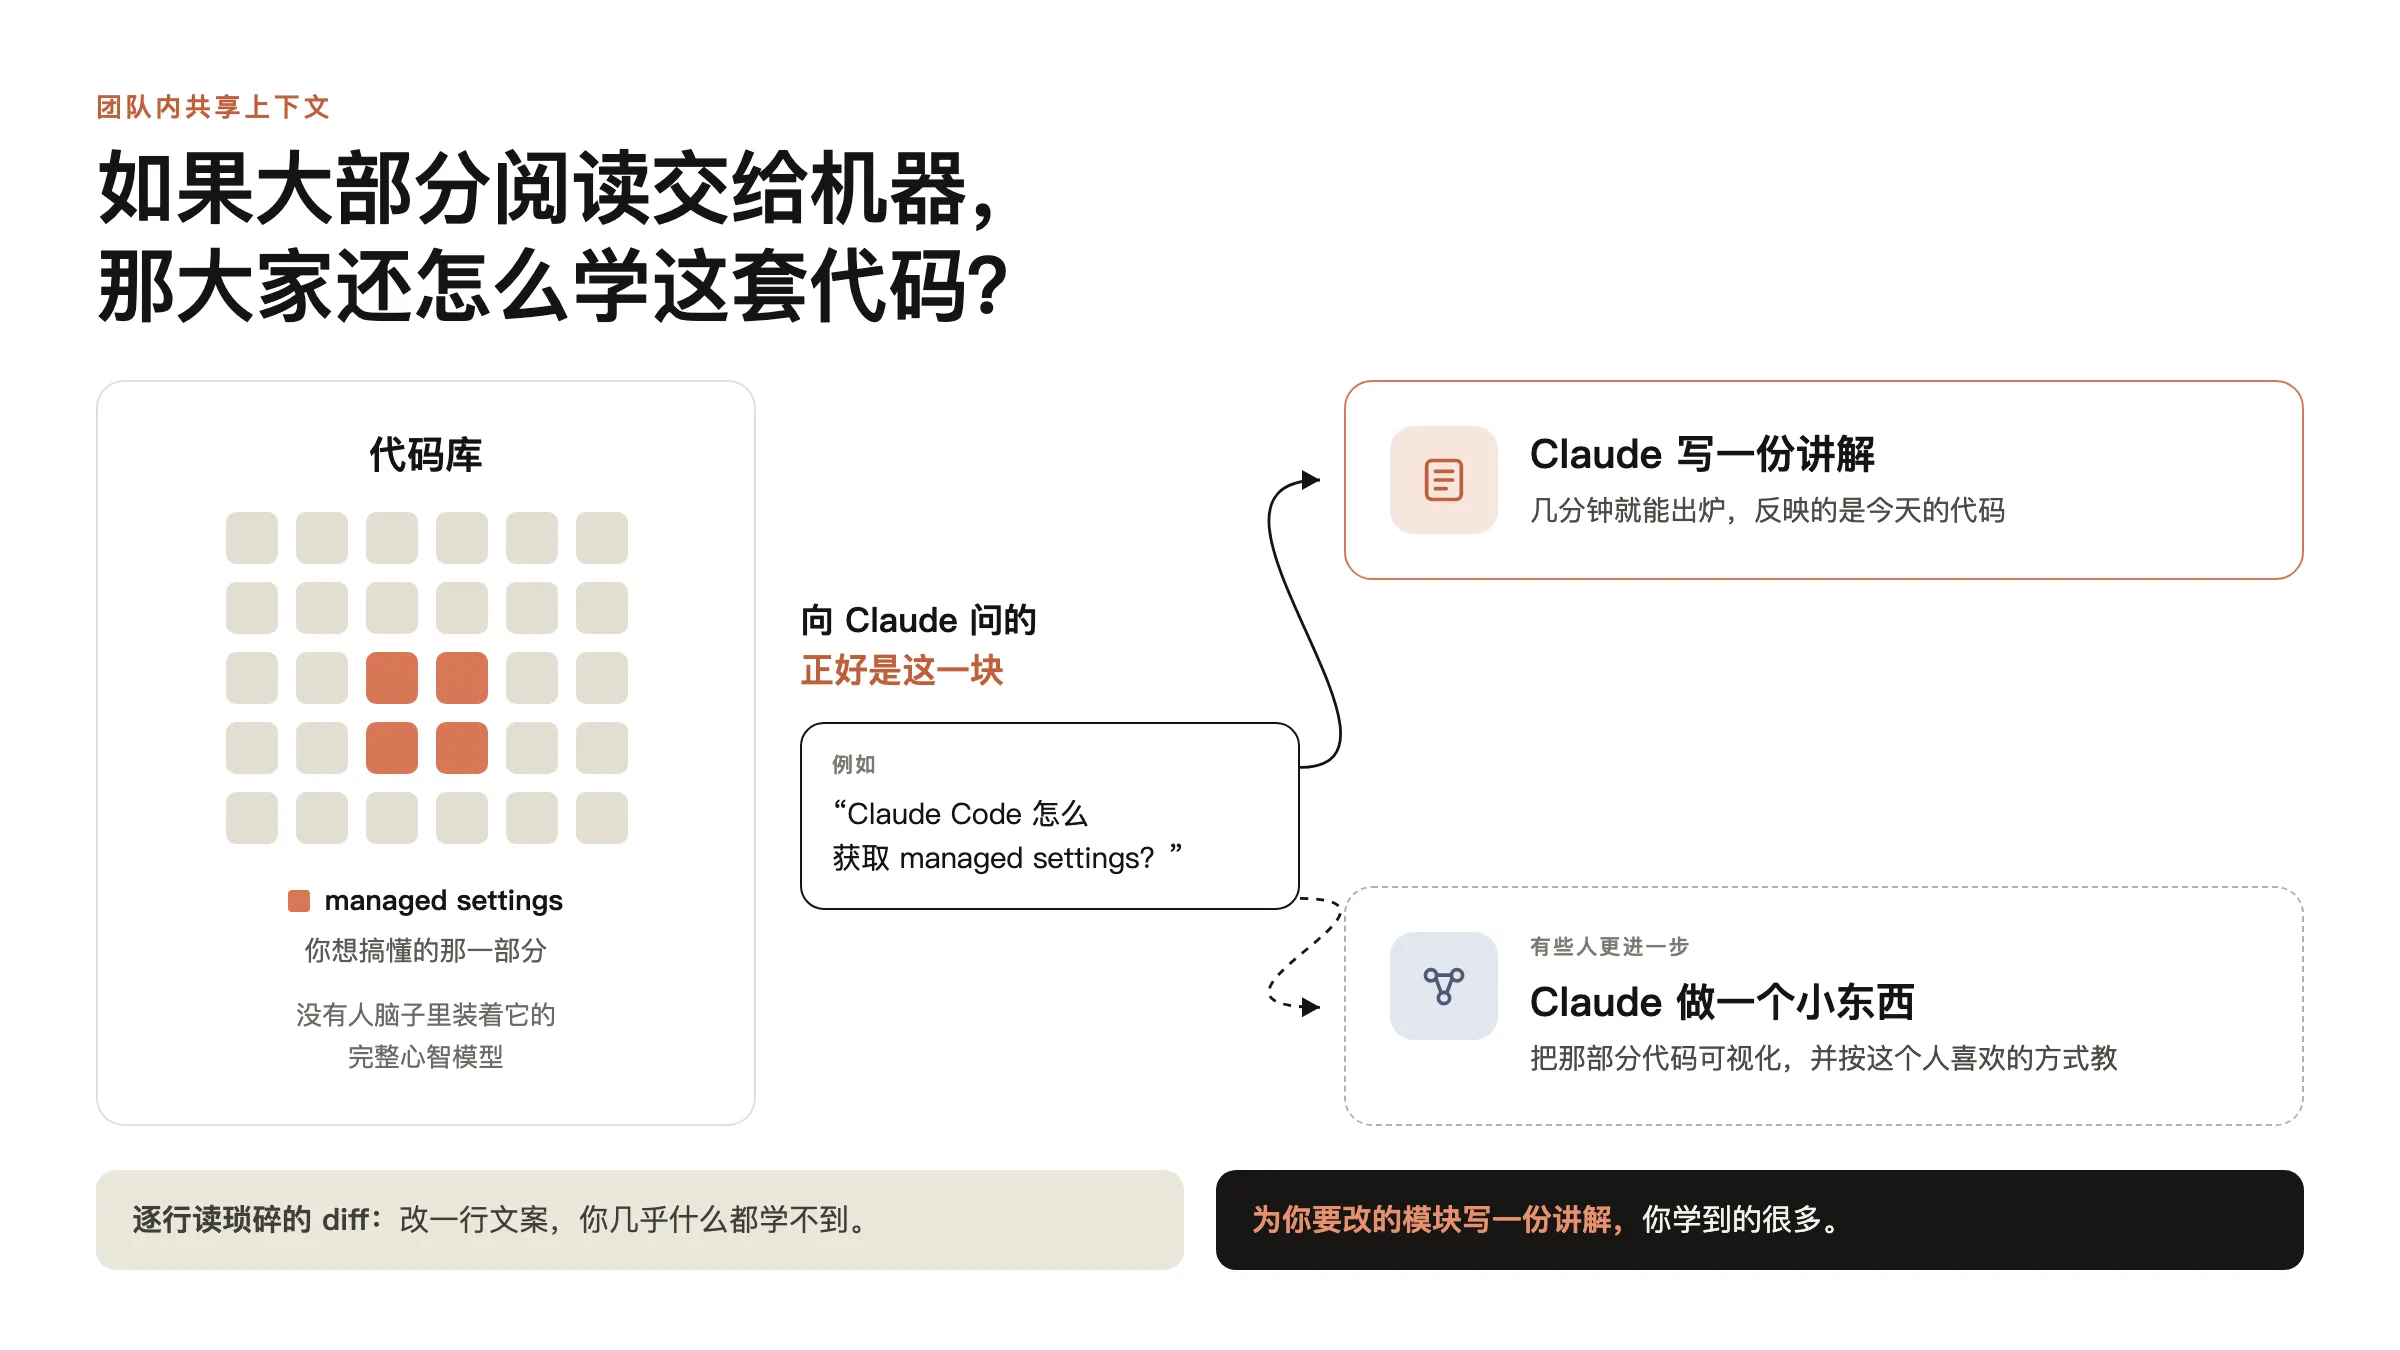
有些人更进一步,让 Claude 做一个小东西,把那块代码可视化,并且按这个人喜欢的学习方式来教。
如果目标是把人的注意力花在合适的地方,这比逐行读那些无关紧要的 diff 强多了。改一行文案,你什么都学不到;为你要改的那个模块写一份讲解,你学到的很多。我们默认在公开的 Slack 频道里干活,这个文化也帮了忙——别人在造什么,你边看边就知道了。
「你合并,你负责」#
如果你合了一个小改动或中等改动,结果还是出了问题,团队的习惯是:通常由你自己来修。有几件事让这个习惯不至于变成灾难:
- 改动小,所以好审、好查、好回滚。
- 一切可逆。开关、回滚、分阶段发布,几分钟就能把大部分错误撤掉。
- 看爆炸半径定标准。贵的代码,参与的人和检查都更多。
- 回归冒头快,有遥测和内部使用兜着。
- 这不是追责。由你来修,是因为你最清楚上下文;事故复盘看的是系统。
责任也是共享的。团队大部分工作都在公开频道里进行,谁都能看到别人在做什么,能接上一个话题,或者把一个 Claude 指到一个缺口上;反馈也来自不拥有这段代码的人。这种开放,是「不靠逐行设卡也能保持质量」的重要部分。
当我们改方向#
agent 让「开始做一件事」变得很便宜,所以总有些工作不该落地。通常频道里会有人问一句为什么,指出之前的某个决定,或者建议一条更简单的路,然后作者把 PR 关掉或者重塑它。
因为代码写得快,关掉 PR 并不觉得是损失。窍门是在讨论串里早一点提出不同方向,而不是等 PR 做完了再留一条阻塞性的评论。
怎么把这套流程搬过去#
这套东西要用在自己团队上,大部分零件今天就已经有了。
开 PR 之前#
- 给 agent 一些它能跑的检查,写在一份简短的
CLAUDE.md里;再加上跑 formatter 和 linter 的 hook。 - 在本地跑
/code-review和/security-review,或者让一个全新上下文的 subagent 审一遍。 - 加一份
REVIEW.md,把重复出现的审查意见搬进去。
每个 PR#
- 要求 CI 通过;在 PR 模板里加三项:「怎么测的」「风险」「怎么撤销」。
- 先在一个仓库上挂 AI 审查(Code Review for Claude Code,或者 Claude Code GitHub Action),花几周调
REVIEW.md,再铺开。 - 加上自动安全审查,并且要求合并前所有审查讨论都已解决。
- 让审查力度跟风险匹配:常规改动快过一遍,漏一个 bug 很贵的地方用深度审查(Code Review 里的 Quick、Standard、Deep)。
- 限制审查轮数;前几轮之后,复审只看新的 diff。
批准#
- 把风险分级写下来,按改动定级而不是按作者;一开始从严,有证据再放宽。
- 轻量批准路径只留给你信得过的作者。
- 用 CODEOWNERS 和分支保护,让 auth、计费、CI 与发布 workflow、安装器永远需要真人。
- 永远不要让 bot 的批准顶替本该由人给的那一份;有新提交时把旧批准清掉。
合并之后#
- 用合并队列、功能开关、内部先用、分阶段发布,以及一步回滚。
- 把事故和回滚变成 eval 集合;审查者的 prompt、工具或模型一变,就重新打分。
- 度量人的时间,把回滚率和事故率当成护栏。
接下来往哪走#
Code Review 的发布公告里说,批准一个 PR 仍然是人的决定;这个产品发布的是发现,不是批准。我们自己的仓库走得更远一些:由 owner 决定哪些低风险改动可以仅凭自动检查就合并,而这条线还在往前挪。
审查漏掉什么的时候,我们问的是「模型当时眼前缺了什么」,然后把补救放进 CLAUDE.md、一个 skill,或者一道新的检查。目标没变:每次改动花的人更少,回滚不比以前多。
如果你的团队也让 agent 提 PR,我们想知道:你们把哪些检查自动化了,哪些仍然需要人,以及你觉得我们哪里想错了。
感谢 Emma Webb、Michael Segner 和 Amie Rotherham 对原文的审阅。
本文译自 Addy Osmani、Morgan Westlee Lunt 和 Qing Wang 的 How the Claude Code team does code review(claude.dev,2026 年 10 月 15 日)。原文的五张示意图是页面内嵌 SVG,一张是位图,译文中的配图都按原文重制为中文。