 Parker
后台 Computer Use 的速度与成本:Codex 自带工具、macOS Harness 与三种模型的对照评测
四种方案并列比较:Electron 上 Codex + Harness 最快最稳,DeepSeek + Harness 两类应用都最便宜
摘要#
本文在 macOS 上对四种 computer use 方案做了并列评测,把每一组都当作一个可以直接选用的独立方案,比较端到端耗时、token 用量、按 API 标价折算的费用、任务成功率和是否抢占前台。这类比较不容易做准:耗时同时受工具执行方式、模型推理和应用行为影响,原生应用和 Electron 应用的界面响应也差别很大。四种方案为 A(Codex CLI + gpt-6.1-sol + 自带 Computer Use)、B(同一 Codex 与模型 + browser-use macOS Harness)、C(Grok Build + grok-4.7 + Harness)和 D(DSH + DeepSeek V4.1 Flash + Harness),其中 A 与 B 只差一个工具,可额外用于分离工具因素;8 个任务覆盖 4 个原生应用和 4 个 Electron 应用,每次运行都自动校验并保留打码录屏。结果显示,原生应用上 A、B、D 的耗时相近(106 s 到 126 s)且全部成功,D 的费用为 0.035 美元,约为 A 的六分之一;Electron 应用上 B 的总耗时为 268 s,A 为 949 s,D 为 885 s,B 的 11 次运行全部成功,而 D 的费用最低,为 0.23 美元,约为 A 的七分之一、B 的一半,但在 VS Code 和 draw.io 上明显变慢。C 在两类应用上都没有领先的指标。
1 引言#
Computer use 让模型通过读取界面和发送点击、按键来操作桌面应用。对日常使用来说,有两点比单次成功率更影响体验:一是它能否在后台运行而不抢走用户的前台窗口,二是完成一个任务要花多少时间和钱。Codex 提供了自带的 Computer Use 插件,browser-use 也发布了开源的 macOS Harness1。两者都把界面表示成带编号的辅助功能树文本,第二次读取起只返回差异,观测格式非常接近。
在这种情况下,仅凭演示视频难以判断两者在速度和成本上的差别,也难以估计换用更便宜的模型会带来多大影响。原生应用和 Electron 应用的界面行为不同,两类应用上的结论也未必一致。
本研究把四种方案视为四个独立的整体,不预设基线,围绕三个问题设计实验:(1)在原生应用和 Electron 应用上,四种方案在速度、成本和可靠性上各自表现如何,每一项由哪一组最优;(2)A 与 B 只差一个工具,这一配对能说明工具本身带来多大差距,差距来自哪里;(3)各组在失败任务上暴露出什么问题。所有数字都来自逐次运行的原始记录,录屏经过打码后保留。
2 实验设计#
2.1 被测配置#
表 1 列出四组配置。本文把每一组当作一个可以直接选用的完整方案并列比较。其中 A 和 B 使用同一个 agent 程序和同一个模型,只更换 computer use 工具,这一配对还可以用来单独分析工具本身的影响。B、C、D 共用同一个 Harness,但 agent 程序和模型同时不同,两者的影响无法分开,第 5 节会再讨论这一点。
| 组 | Agent 程序 | 模型(推理强度) | Computer use 工具 |
|---|---|---|---|
| A | Codex CLI 0.163.0-alpha.10.2 | gpt-6.1-sol(high) | Codex 自带 Computer Use 插件(JS REPL 形式的 MCP 工具) |
| B | 同 A | 同 A | macos-harness 0.2.1(11 条 shell 命令) |
| C | Grok Build 1.0.62 | grok-4.7(high) | 同 B |
| D | DSH 0.2.0-rc.2 | DeepSeek V4.1 Flash 1017(high) | 同 B |
D 的模型版本做过核实。DeepSeek 官方 API 只接受 deepseek-flash 这个名字,/models 返回 DeepSeek-V4.1-Flash,官方价格页说明该名称由 1017 checkpoint 提供服务2。评测前后各记录了一次 system_fingerprint,两次都是 e72d3c7f663d3e1383b00b3884cb4501,说明所有运行都落在同一个 checkpoint 上。D 的推理强度选了 high,也就是 max 下面一档。
为了确认两种工具的输入信息量是否相当,评测分别用两种工具读取了 4 个 Electron 应用的界面(表 2)。两者读到的元素数接近,都能拿到 URL 和完整的树。
| 应用 | Harness | Codex 自带 CU |
|---|---|---|
| VS Code | 126 | 128 |
| Obsidian | 67 | 75 |
| draw.io | 46 | 56 |
| AFFiNE | 71 | 108 |
2.2 任务与校验#
8 个任务都选了能自动校验结果的操作(表 3)。Electron 应用全部用 --user-data-dir 指向隔离的配置目录启动,不接触机主自己的数据。Postman 因为登录了真实账号被排除,Xmind 在 macOS 27 Beta 上启动即崩溃,也被排除。
| 类型 | 任务 | 校验方式 |
|---|---|---|
| 原生 | Calculator:点按钮计算 (a×b)−c 并读出结果,每轮换一组数 | 回答中的数字 |
| 原生 | TextEdit:新建文档,输入两行,用保存对话框存到指定目录后关闭窗口 | textutil 逐行比对,并确认窗口已关闭 |
| 原生 | System Settings:读出“关于本机”中的系统版本和芯片型号 | 与 sw_vers、sysctl 比对 |
| 原生 | Finder:从零导航到深层路径,新建文件夹并改名 | 目录存在且没有残留的 untitled folder |
| Electron | VS Code 1.115:两处改名,在文件首行插入注释并保存 | 文件内容逐行比对 |
| Electron | Obsidian 1.8:新建笔记,写入标题、两条待办和一个 [[链接]] | .md 文件逐行比对 |
| Electron | draw.io 19.0:画两个矩形和一条箭头,保存为 .drawio | 解析 XML 中的顶点文字和边的 source/target |
| Electron | AFFiNE:新建页面,写入标题、正文和一个待办块 | 独立的辅助功能树读取器检查三段文字和复选框图标 |
2.3 运行控制与审计#
每次运行都在全新的工作目录中启动,A、B 两组按轮交替先后。Electron 和 Finder 任务开始前,脚本会先把前台切回终端,用于测量 agent 是否把目标应用拉到前台。每次运行的超时上限为 600 s。评测流程如下图所示。
越界审计检查三类行为:A 组不得调用 macos-harness,B、C、D 组不得调用 Codex 自带工具,四组都不得用 shell 直接完成任务(写文件、建目录、算结果)。全部运行中越界次数为 0。D 组有一些只读的自检命令,单独统计,见 3.7 节。
2.4 指标与统计方法#
端到端耗时从 agent 进程启动计到退出。输入 token 统计包含缓存命中部分的完整 prompt,输出 token 包含推理 token。超时被终止的运行从会话日志补录 token;对 Grok,按每条消息的 usage 求和补录,这一方法在 8 次完整运行上与最终汇总逐位一致。费用按 2026 年 10 月的公开 API 标价折算(表 4),Grok 的折算结果与 CLI 自报的 total_cost_usd 一致。
| 模型 | 非缓存输入 | 缓存输入 | 输出 |
|---|---|---|---|
| gpt-6.1-sol | 2.00 | 0.10 | 10.00 |
| grok-4.7 | 2.00 | 0.50 | 6.00 |
| DeepSeek V4.1 Flash(高峰) | 0.30 | 0.006 | 1.20 |
DeepSeek 在非高峰时段半价。本次评测在周六进行,全程处于非高峰时段,下文 D 的“费用”统一按高峰标价计算,实际扣费另列为“实付”。A、B 两组实际消耗的是 ChatGPT 订阅额度,表中的费用是 API 等价值。
样本量方面,A、B、D 每个任务各运行 3 次(A、B 的 Finder 各 6 次,AFFiNE 各 2 次),C 每个任务运行 1 次。组间比较采用分层置换检验:在每个任务内部打乱组别标签,统计量为各任务中位数之比取对数后的平均,重复 20,000 次。C 每个任务只有 1 次运行,涉及 C 的检验能达到的最小 p 值约为 0.004,相关结论偏参考性。
3 结果#
3.1 整套任务的总体结果#
表 5 汇总了整套 8 个任务的结果,每个任务先取中位数再加总。按这一口径,B 的总耗时最短(394 s),也是唯一全部成功的一组;D 的标价费用最低(0.27 美元);A 和 C 在耗时和费用上都不占优。不过整套加总把原生应用和 Electron 应用混在一起,而两类应用上的排序并不相同,因此 3.2 和 3.3 节分开报告。
| 组 | 总耗时 | 输入 token | 其中非缓存 | 输出 token | 费用(标价) | 成功率 |
|---|---|---|---|---|---|---|
| A:Codex + 自带 CU | 1059 s | 9.82 M | 320k | 18.3k | $1.77 | 25/26 |
| B:Codex + Harness | 394 s | 2.13 M | 221k | 8.1k | $0.72 | 26/26 |
| C:Grok + Harness | 1573 s | 3.83 M | 485k | 75.5k | $3.10 | 7/8 |
| D:DeepSeek + Harness | 991 s | 14.25 M | 219k | 96.9k | $0.27(实付 $0.13) | 22/24 |
图 1 | 整套任务总耗时
8 个任务各取中位数后加总,越低越好
图 2 | 整套任务费用(API 标价)
8 个任务各取中位数后加总,越低越好
表 6 给出逐任务的耗时中位数和范围,是后面各小节分析的基础。
| 任务 | A | B | C | D |
|---|---|---|---|---|
| Calculator | 19.6 [18.3–19.9] | 21.7 [21.5–26.0] | 59.7 | 10.0 [9.0–16.4] |
| TextEdit | 35.3 [33.9–35.9] | 39.3 [38.4–43.6] | 98.2 | 27.9 [25.1–32.0] |
| System Settings | 20.4 [20.1–23.0] | 21.7 [21.7–23.1] | 88.1 | 13.6 [12.3–14.9] |
| Finder | 34.9 [25.7–41.6] | 43.0 [29.1–56.5] | 189.6 | 54.2 [44.2–115.0] |
| VS Code | 182.3 [162.2–316.5] | 39.3 [37.6–41.7] | 211.3 | 511.2 [153.0–600.0†] |
| Obsidian | 157.3 [87.0–179.3] | 42.2 [36.4–45.3] | 219.2 | 35.3 [34.4–42.8] |
| draw.io | 133.9 [109.9–154.2] | 100.6 [85.2–136.0] | 600.0† | 305.5 [143.7–377.9] |
| AFFiNE | 475.6 [351.1–600.0†] | 85.8 [84.9–86.7] | 106.5 | 33.0 [30.5–46.6] |
3.2 原生应用:A、B、D 速度相当,D 费用最低#
表 7 汇总了 4 个原生应用上的结果。A、B、D 三组的总耗时在 106 s 到 126 s 之间,全部运行都成功;C 的总耗时为 436 s,是其余三组的 3 到 4 倍。费用上,D 为 0.035 美元,A 为 0.207 美元,B 为 0.266 美元,C 为 0.973 美元。
| 组 | 总耗时 | 输入 token | 输出 token | 费用(标价) | 成功率 |
|---|---|---|---|---|---|
| A:Codex + 自带 CU | 110 s | 0.59 M | 1.2k | $0.207 | 15/15 |
| B:Codex + Harness | 126 s | 0.64 M | 2.1k | $0.266 | 15/15 |
| C:Grok + Harness | 436 s | 1.16 M | 18.8k | $0.973 | 4/4 |
| D:DeepSeek + Harness | 106 s | 0.80 M | 7.5k | $0.035 | 12/12 |
图 3 | 原生应用逐任务耗时
四组配置,中位数,越低越好
- A Codex + 自带 CU
- B Codex + Harness
- C Grok + Harness
- D DeepSeek + Harness
分层检验的结果(表 9)显示,A、B、D 三组之间的耗时差异都在 40% 以内,其中只有 A 与 B 的差异达到 p < 0.05(A/B = 0.89,p = 0.037);A/D 为 1.24(p = 0.15),B/D 为 1.40(p = 0.081)。逐任务看,D 在 Calculator、TextEdit、System Settings 上最快,A 在 Finder 上最快。费用的差异则很明确:A 的费用是 D 的 6.87 倍,B 是 D 的 8.15 倍,两项都是 p < 0.001。
A 与 B 只差一个工具,原语微基准可以解释两者在原生应用上的小差距。在 Calculator 上各测 10 次,A 的完整读取中位数为 88 ms,B 为 296 ms(B 每次读取都会截图);A 的点击为 28 ms,B 为 67 ms(B 每条命令启动一个进程)。不过端到端耗时中约 75–80% 花在模型推理上,原语层面 2 到 3 倍的差距只转化为约 10% 的总耗时差距。
3.3 Electron 应用:B 最快最稳,D 最便宜#
Electron 应用上四组的差距明显拉开(表 8)。B 的总耗时为 268 s,A 为 949 s,D 为 885 s,C 为 1137 s;B 的 11 次运行全部成功,A 为 10/11,D 为 10/12,C 为 3/4。费用上,D 为 0.234 美元,B 为 0.452 美元,A 为 1.566 美元,C 为 2.125 美元。
| 组 | 总耗时 | 输入 token | 输出 token | 费用(标价) | 成功率 |
|---|---|---|---|---|---|
| A:Codex + 自带 CU | 949 s | 9.23 M | 17.1k | $1.566 | 10/11 |
| B:Codex + Harness | 268 s | 1.49 M | 6.0k | $0.452 | 11/11 |
| C:Grok + Harness | 1137 s | 2.67 M | 56.7k | $2.125 | 3/4 |
| D:DeepSeek + Harness | 885 s | 13.44 M | 89.4k | $0.234 | 10/12 |
图 5 | Electron 应用逐任务耗时
四组配置,中位数,越低越好
- A Codex + 自带 CU
- B Codex + Harness
- C Grok + Harness
- D DeepSeek + Harness
速度方面,B 显著快于 A(A/B = 3.36,p = 0.001)和 C(B/C = 0.26,p = 0.006)。B 与 D 的关系取决于任务:D 在 Obsidian(35 s 对 42 s)和 AFFiNE(33 s 对 86 s)上快于 B,在 VS Code 上慢 13 倍,在 draw.io 上慢 3 倍,逐任务几何平均 B/D 为 0.53,未达显著(p = 0.25)。D 与 A 也是各胜两项:D 在 Obsidian 和 AFFiNE 上远快于 A,在 VS Code 和 draw.io 上慢于 A(A/D = 1.78,p = 0.43)。A 与 C 之间耗时没有显著差异(A/C = 0.89,p = 0.73)。
费用方面,D 在 4 个任务中有 3 个最便宜,只有 VS Code 上 B 更便宜(0.063 美元对 0.141 美元)。D 显著便宜于 A(A/D = 11.25,p < 0.001)和 C(C/D = 14.74,p = 0.004);相对 B,D 的总费用约为一半,逐任务几何平均 B/D 为 3.34,但未达显著(p = 0.089)。
可靠性方面,B 是唯一全部成功的一组,并且耗时波动最小:B 在 4 个 Electron 任务上的最大与最小耗时之比都不超过 1.6,D 在 VS Code 上这一比值为 3.9。A 的失败是一次 AFFiNE 超时,D 的两次失败分别是 VS Code 超时和 AFFiNE 待办块未生成(见 3.7 节),C 的失败是 draw.io 超时。
图 7 和图 8 是 Obsidian 与 draw.io 任务的对齐录屏,可以直接看到上述差异。VS Code 任务的录屏正在重新整理,稍后补上。
3.4 两两比较与各项最优#
表 9 列出全部 6 种两两组合的分层检验结果。比值是“前者除以后者”的逐任务几何平均,大于 1 表示前者耗时更长或费用更高;括号内为双侧 p 值。涉及 C 的比较每个任务只有 1 次运行,p 值偏参考性。
| 比较 | 原生:耗时 | 原生:费用 | Electron:耗时 | Electron:费用 |
|---|---|---|---|---|
| A / B | 0.89(0.037) | 0.84(0.096) | 3.36(0.001) | 3.37(< 0.001) |
| A / C | 0.27(0.002) | 0.24(0.002) | 0.89(0.73) | 0.76(0.39) |
| A / D | 1.24(0.15) | 6.87(< 0.001) | 1.78(0.43) | 11.25(< 0.001) |
| B / C | 0.30(0.002) | 0.29(0.002) | 0.26(0.006) | 0.23(0.006) |
| B / D | 1.40(0.081) | 8.15(< 0.001) | 0.53(0.25) | 3.34(0.089) |
| C / D | 4.67(0.004) | 28.07(0.004) | 2.01(0.089) | 14.74(0.004) |
把以上结果按指标归纳为表 10。没有一组在所有指标上都最优:B 在 Electron 上的速度和可靠性最好,D 在两类应用上的费用都最低,A 在原生应用上与 B、D 相当,C 在本次评测的各项指标上都没有领先。
| 指标 | 原生应用 | Electron 应用 |
|---|---|---|
| 速度 | A、B、D 相当(106–126 s),C 慢 3 到 4 倍 | B 最快(268 s),显著快于 A、C;与 D 的差异因任务而异 |
| 费用 | D 最低($0.035),显著低于 A、B、C | D 最低($0.234),显著低于 A、C;约为 B 的一半,未达显著 |
| 成功率 | A、B、D 均为 100%,C 为 4/4 | B 11/11,A 10/11,D 10/12,C 3/4 |
| 耗时稳定性 | A 最稳定(最大/最小 ≤ 1.7),B ≤ 2.0,D 在 Finder 上为 2.6 | B 最稳定(最大/最小 ≤ 1.6),D 在 VS Code 上为 3.9 |
| 不抢前台 | B、C、D 为 0;A 在 Finder 上 5/5 次抢前台 | A、C 为 0;B 1 次(应用自行激活);D 2 次(模型主动激活) |
3.5 A 与 B 的配对:工具本身的差距从何而来#
A 与 B 使用同一个模型,Electron 上 3.36 倍的耗时差距和 5.94 倍的输入 token 差距(p = 0.0005)可以归因于工具。为了解释这一差距,评测从 Codex 会话日志中取出每次 Computer Use 调用的执行耗时(表 11)。Electron 应用上,24% 的调用耗时不低于 4.5 s,这些慢调用合计占 A 工具时间的 70%。同时有 49 次调用(10%)返回 The user changed …,即工具认为用户改动了应用,于是中止当前这批动作。原生应用上,这两个数字分别是 6% 和 4 次。B、C、D 三组的此类误报都是 0 次。
| 应用类型 | 调用次数 | 耗时中位数 | ≥ 4.5 s 的调用 | 慢调用占工具时间 | “用户改动”误报 |
|---|---|---|---|---|---|
| 原生 | 70 | 1183 ms | 4(6%) | 21 s / 105 s | 4 |
| Electron | 471 | 757 ms | 113(24%) | 626 s / 896 s(70%) | 49(10%) |
nodeReplExecutionDurationMs。典型的失败链路出现在 VS Code 的一次运行中。A 选中文字后调用 paste,选区没有被替换;改用 typeText 后又遇到自动缩进和自动补全;随后动作返回“用户改动了应用”,整批中止,耗时约 5 s;重新读取界面后再重试。这次运行最后把整个文件逐行重新输入,共用了 52 轮调用和 242 万输入 token。B 在同一任务上先用 select_text 选中,再用 type_text 覆盖,6 轮完成。AFFiNE 上也出现了类似情况,A 的输入出现字符顺序错乱和按键不生效。
这些结果表明,两种工具在 Electron 上的差距主要不来自“能读到多少”(表 2 中两者相近),而来自动作的执行方式和等待界面稳定的策略。慢调用拉长了工具时间,误报打断了动作批次,后者又引发更多读取和重试,使上下文更长,输入 token 随之增加。
3.6 费用差异的来源#
图 9 给出四组的逐任务费用。D 的输入 token 总量是四组中最多的(14.25 M),费用却最低,原因在价格结构:四组的缓存命中率都在 84% 到 92% 之间,而 DeepSeek 缓存输入的单价为每百万 0.006 美元,约为 GPT 的十七分之一、Grok 的八十三分之一。Computer use 每一轮都要重发整段界面历史,缓存单价因此成为决定成本的主要因素。D 全部 24 次运行(含失败)的实付总额为 0.38 美元。
C 的费用最高,有两个原因。一是输出 token 多,是 B 的 2.6 到 16.8 倍,模型 API 时间占 C 总耗时的 68% 到 85%;二是 Grok 的缓存单价为每百万 0.50 美元,是 GPT 的 5 倍,长上下文重发因此更贵。
图 9 | 逐任务单次运行费用
中位数,按 API 标价折算,越低越好
- A Codex + 自带 CU
- B Codex + Harness
- C Grok + Harness
- D DeepSeek + Harness
3.7 失败案例与自检行为#
D 的两次失败都值得单独说明。第一类是复杂编辑任务上的反复确认。表 12 对比了 B 与 D 在 VS Code 上的动作次数。D 的日志中多次出现“键盘输入没有到达应用”“读取落后于动作”之类的判断,随后撤销、换用菜单 Revert File、set_value 整段覆盖或搜索视图核对,每换一次方法都要重新读树确认。d2 这次运行在 600 s 时超时,文件首行已被改坏,累计输入 1196 万 token。
| 运行 | 读取界面 | 按键 | 点击 | 结果 |
|---|---|---|---|---|
| B(e2) | 5 | 4 | 0 | 39 s 成功 |
| D d1 | 25 | 19 | 10 | 153 s 成功 |
| D d2 | 129 | 34 | 46 | 600 s 超时 |
| D d3 | 115 | 55 | 45 | 511 s 成功 |
第二类是模型自报成功而实际未完成。在 AFFiNE 的 d2 运行中,模型报告“待办事项块带有空的复选框”,但页面上 check dsh d2 前面只有普通段落的拖拽手柄,没有复选框(图 10)。校验器判定这次运行失败是正确的。
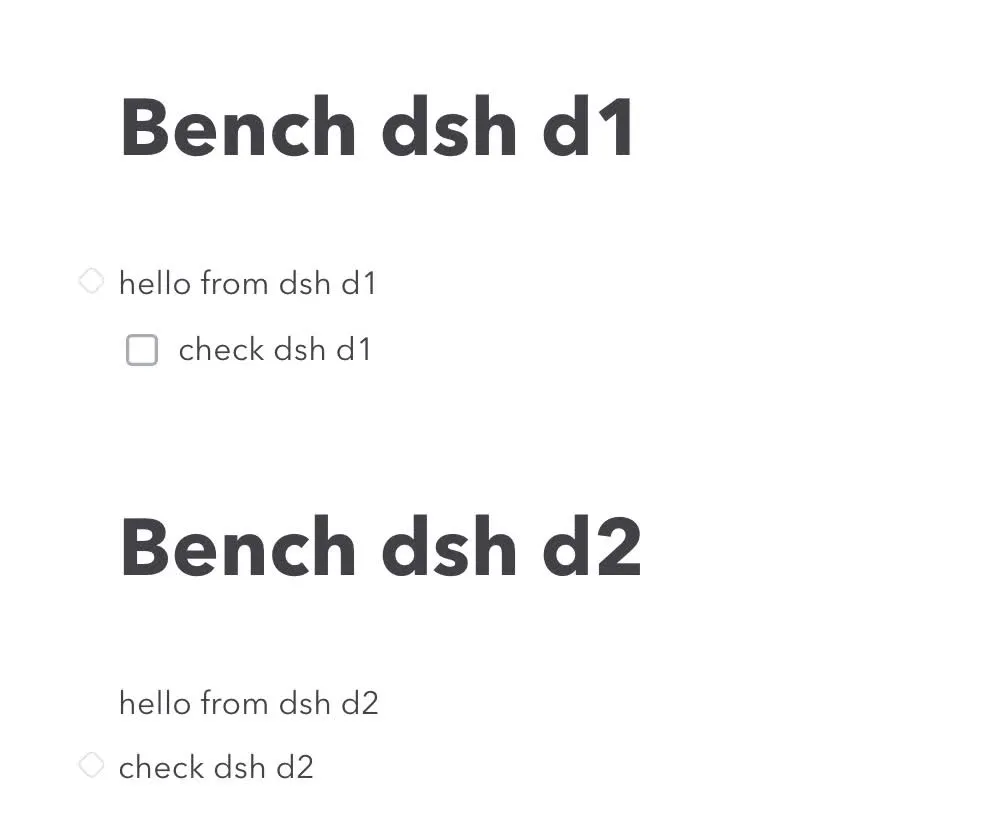
C 的失败发生在 draw.io。它在 5 分钟里一直没有关掉启动对话框,最后在保存对话框里用 set_value 填了文件名,但值没有作为键盘输入生效,“Save”按钮保持灰色,600 s 超时。
另外,D 是唯一会绕开界面去确认结果的一组。它有 59 条非 Harness 的 shell 命令,其中 39 条是把读树结果存到临时文件后用 grep、sed 过滤,属于正常使用;18 条出现在 5 次运行中,用 ls、cat、python 读取自己刚通过界面保存的 .drawio 或 .rtf 文件来核对;2 条是环境探测。这些命令全部只读,任务结果都是通过界面完成的,因此没有判为越界。B 和 C 此类命令为 0。
3.8 后台运行#
“抢前台”定义为目标应用在开始时不在前台、运行中却被切到前台。Harness 本身在全部运行中都没有抢前台。A 在干净起点的 Finder 导航中 5 次全部把 Finder 切到前台,其余 7 个应用为 0。D 在 VS Code 上有 2 次切换,均来自模型的主动操作:一次点击了窗口标题栏,一次在 Window 菜单中点击了“Bring All to Front”,起因都是它判断按键没有到达应用。B 在 AFFiNE 上有 1 次切换,是 agent 按 ⌘R 刷新后应用自己激活了窗口。
4 讨论#
第一,四组配置之间不存在一个在所有指标上都最优的方案,最优选择取决于应用类型和关注的指标。原生应用上,A、B、D 的速度和成功率相当,D 的费用低一个数量级;Electron 应用上,B 在速度、成功率和耗时稳定性上领先,D 的费用最低但在复杂编辑任务上耗时波动大。按这一结果,以 Electron 应用为主、看重稳定性的工作流更适合 B;以原生应用或简单任务为主、对成本敏感的场景更适合 D;A 在原生应用上可用,但在 Electron 上的速度和费用都不占优;C 在本次评测中没有领先的指标。
第二,A 与 B 的配对表明,工具之间的差距取决于应用类型。原生应用的界面在动作后很快稳定,两种工具的差异主要体现在原语延迟上,而原语延迟只占端到端耗时的一小部分,所以总耗时只差约 10%。Electron 应用的界面在输入后会持续变化(自动补全、自动缩进、异步渲染),这时工具如何等待、如何判断“界面是否被外部改动”变得更重要。表 11 的数据提示,Codex 自带工具的等待策略和改动检测在 Electron 上过于保守,误报会打断动作批次并引发重试。这一解释与 3.5 节的 VS Code 失败链路一致,但本研究没有修改工具参数做消融,因此它仍是基于日志的推断。
第三,在 computer use 场景中,成本主要由缓存输入的单价决定,而不是由 token 总量决定。四组的缓存命中率相近,D 的输入 token 最多,费用却最低;C 的输入 token 少于 A,费用却高于 A。对需要长时间运行的桌面 agent 来说,选择模型时比较缓存单价可能比比较常规输入单价更有参考价值。
第四,在工具相同时,模型的操作策略决定了复杂任务的稳定性。D 在简单任务上推理步短、速度快,但在 VS Code 这类输入反馈不直观的编辑器中,会把“读取尚未反映动作”误判为“动作没有生效”,进而反复重试。B 在同一任务上只读取 5 次。这说明 Harness 提供的动作原语(如 select_text 后直接 type_text)能否被模型稳定地选用,同样影响结果。
第五,模型的自我报告不能代替结果校验。AFFiNE d2 的“假成功”和 D 的磁盘自检行为都提示,评测 computer use 时应以应用中的实际产出为准,并在更严格的设置下用沙箱隔离输出目录,或在提示词中明确禁止读取输出文件。
5 局限#
本研究的结论应在以下范围内理解。样本量方面,A、B、D 每个任务只有 3 次运行,C 只有 1 次;原生应用上 A、B 的差距只有耗时一项达到 p < 0.05,Electron 上的 3 到 6 倍差距三项均显著。混杂因素方面,B、C、D 同时更换了 agent 程序和模型,无法把两者的影响分开,D 的结果应理解为“DSH 与 DeepSeek V4.1 Flash 这一组合”的表现。任务覆盖方面,draw.io 的多数运行中模型选择了 Edit Diagram 直接写 XML,测到的更多是对话框和文本域操作,而不是画布拖拽。
数据处理上有三处需要说明。draw.io 重启时会自动打开上一次会话的文件,评测发现有 5 次运行开局时画布上已有目标图形,这 5 次全部剔除,并改为每次运行使用全新的空配置目录后补跑。Finder 的早期版本因重置脚本没能关掉目标窗口而被修复后的版本替代;AFFiNE 第 1 轮因判定规则写错而作废。所有被剔除运行的原始记录和剔除原因都保留在数据中。超时运行的耗时记为 600 s,是真实耗时的下限。
录屏方面,窗口画面约每秒截取一次,看不到 Harness 自己绘制的指针悬浮层,也看不到作为独立窗口弹出的保存对话框。评测期间机主偶尔在使用电脑,“抢前台”指标只统计目标应用是否被切到前台,不受影响;光标移动无法归因,因此没有作为结论。
6 结论#
综合来看,这些结果表明,四种 computer use 方案各有所长,没有一种在所有指标上都最优。原生应用上,Codex + 自带 CU、Codex + Harness 和 DeepSeek + Harness 的速度相当且全部成功,DeepSeek + Harness 的费用约为前两者的六分之一到八分之一。Electron 应用上,Codex + Harness 的速度、成功率和耗时稳定性都最好,比 Codex + 自带 CU 快 3.36 倍、便宜 3.37 倍;DeepSeek + Harness 的费用最低,并在 Obsidian 和 AFFiNE 上最快,但在 VS Code 和 draw.io 上明显变慢。Grok + Harness 在本次评测中没有领先的指标。
对实际使用的启示是:以 Electron 应用为主、看重稳定性的工作流更适合 Codex + Harness;以原生应用或简单任务为主、对成本敏感的场景更适合 DeepSeek + Harness,但需要以应用中的实际结果做校验。后续工作可以在三个方向扩展:对 Codex 自带工具的等待和改动检测参数做消融,以验证 3.5 节的推断;在同一个 agent 程序下更换模型,把模型因素和 agent 因素分开;以及加入更多需要画布拖拽和多窗口切换的任务。
数据说明#
评测于 2026 年 10 月 17 日在一台 MacBook Pro 14 英寸(M1 Pro,32 GB,macOS 27.0 Beta)上完成,主分析共 84 次运行;另有 7 次因起点污染或判定规则错误被剔除,早期 Finder 版本和冒烟测试的运行也不计入主分析。每次运行保留了完整提示词、校验结果、工具调用序列、每 0.2 s 的前台应用采样和打码录屏。公开录屏对机主姓名、Apple 账户、序列号等文字做了 OCR 识别并遮挡,并在发布前按每秒 2 帧做过复查。
Notes
-
browser-use/macos-harness,https://github.com/browser-use/macos-harness ↩
-
DeepSeek API 价格,https://api-docs.deepseek.com/quick_start/pricing ↩ ↩2
-
OpenAI,Introducing GPT-6.1 Sol,https://openai.com/index/introducing-gpt-6-1-sol/ ↩
-
grok-4.7 价格汇总,https://www.eesel.ai/blog/grok-4-7-pricing ↩